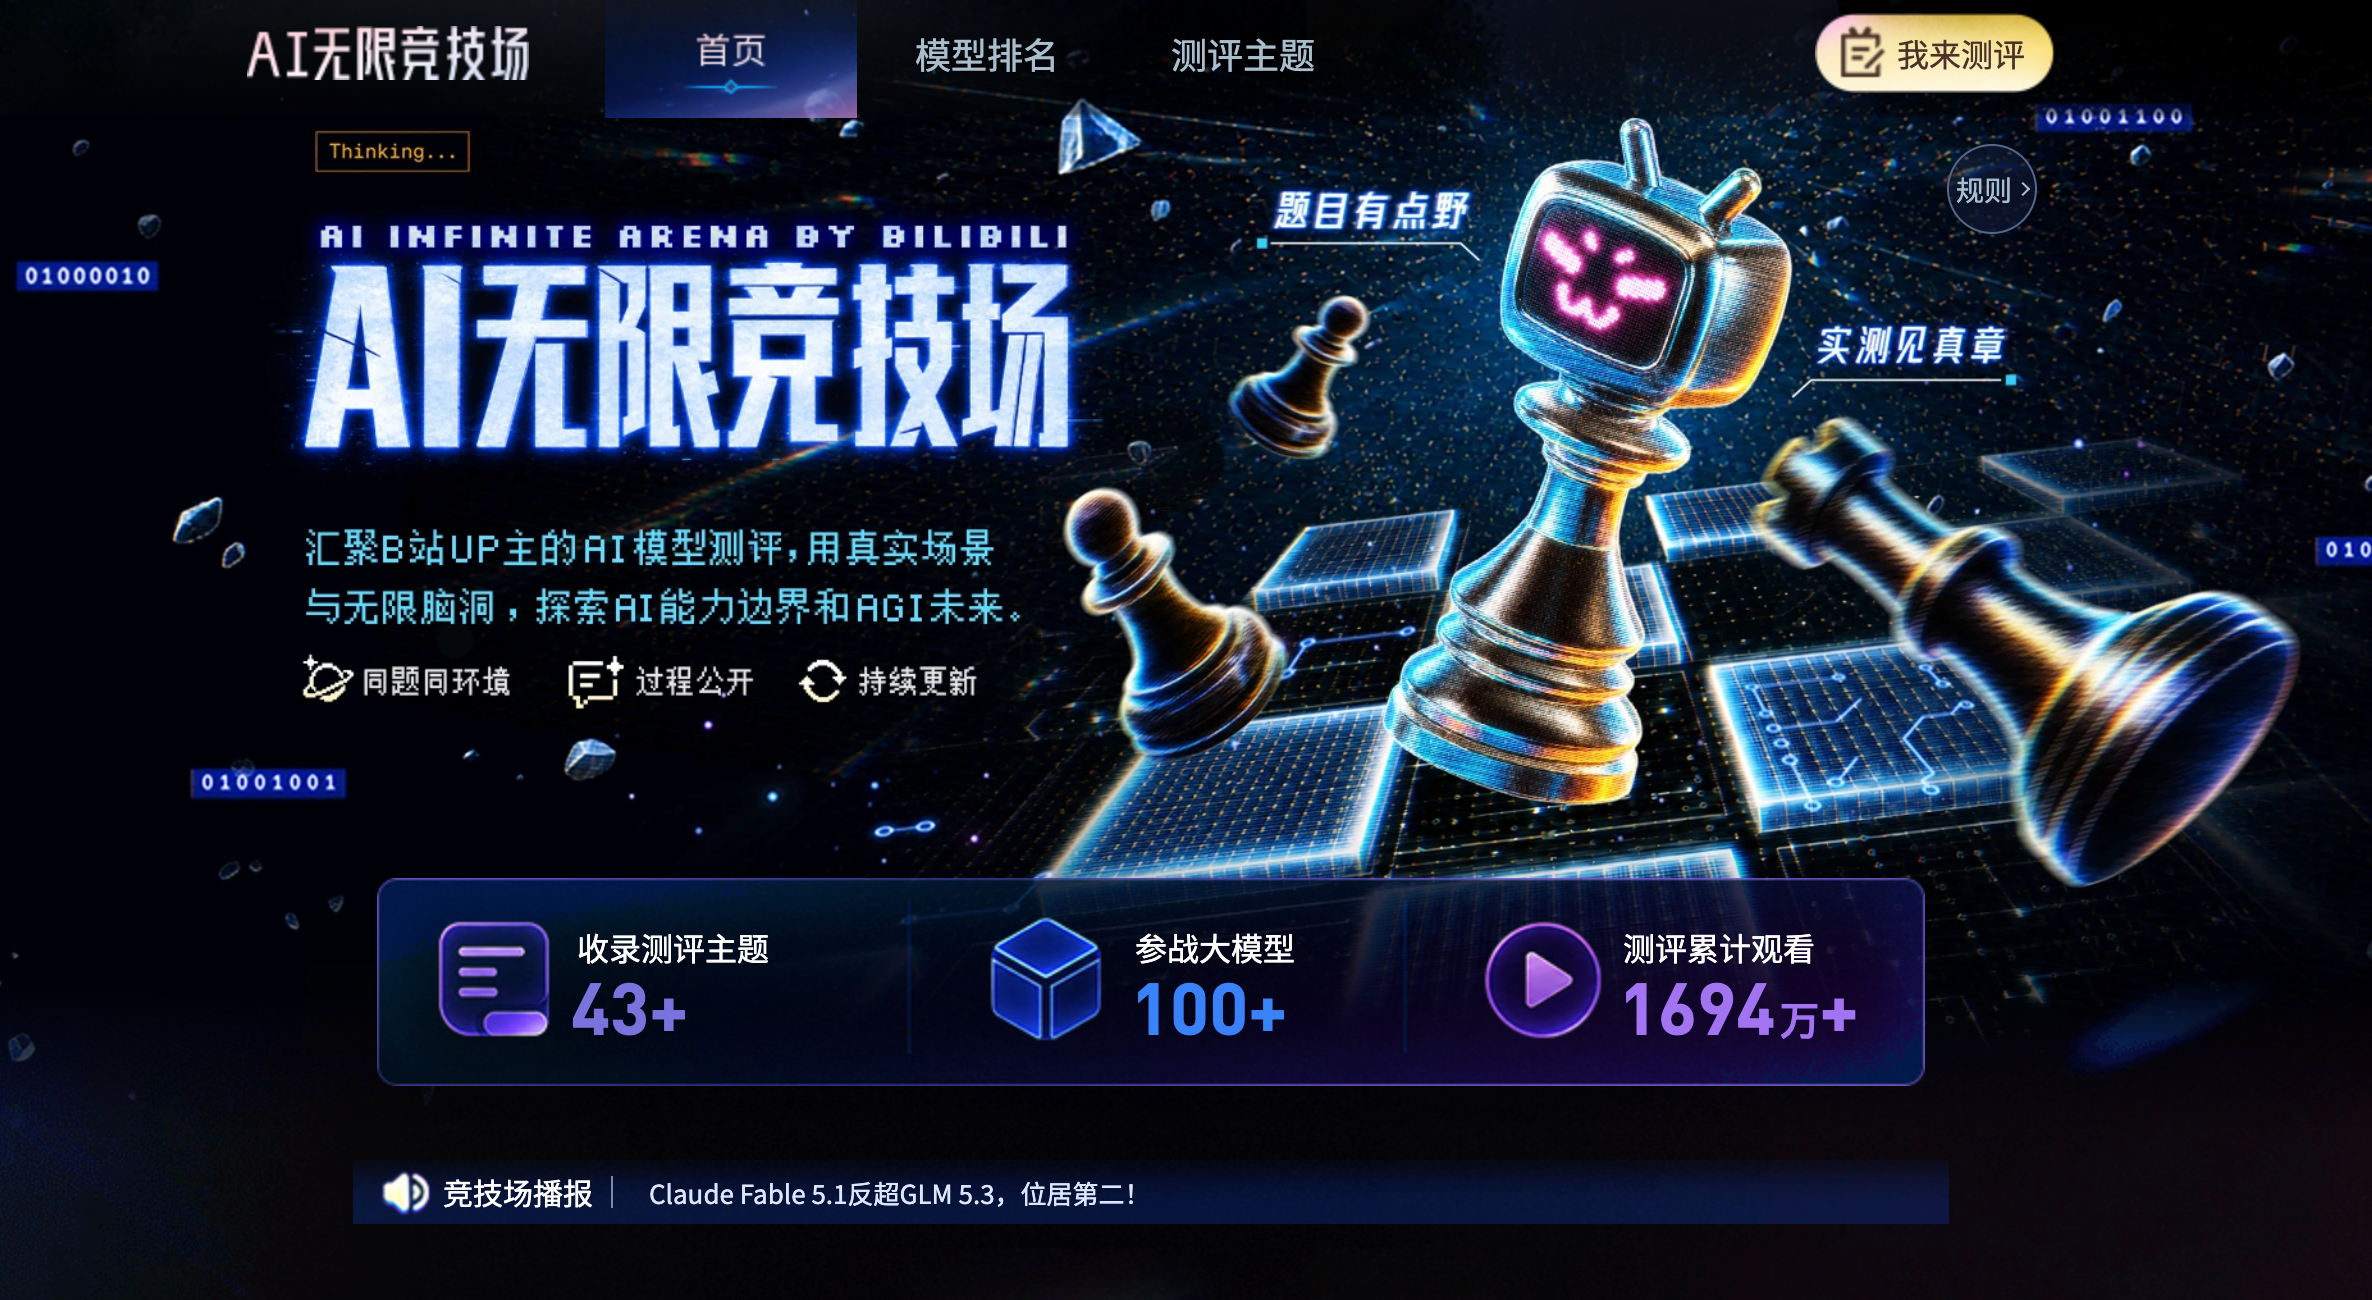
9月20日,B站正式上线“AI无限竞技场”大模型测评榜,同步公布首轮排行榜。在10位UP主的真机实测中,GPT-6 Astra拿下榜首并夺得“登顶次数冠军”,将GLM-5.3压在身后。前五名中,国产大模型占据三席,与海外巨头贴身肉搏。
一条“不设考题”的赛道
“AI无限竞技场”与传统跑分榜的玩法截然不同。它不设固定的测评维度和主题限制,来自不同分区的UP主拿真实工作流、专业应用乃至趣味脑洞自主命题,在同题PK中将模型的实际差距摊开给人看。榜单涵盖DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy、MiniMax等主流模型,排名实时刷新,并持续向全站UP主开放报名。
从首轮榜单数据来看,竞争格局远比想象中胶着。GPT-6 Astra以12次榜首、22次被测、54.55%的榜首率稳居第一;Claude Fable 5.1以6次榜首、50%的榜首率紧随其后;GLM-5.3与GPT-5.6 Sol并列第三,各拿下3次榜首。Kimi K3、DeepSeek-V4-Pro、Qwen3.8-Max等国产模型也均有登顶记录。
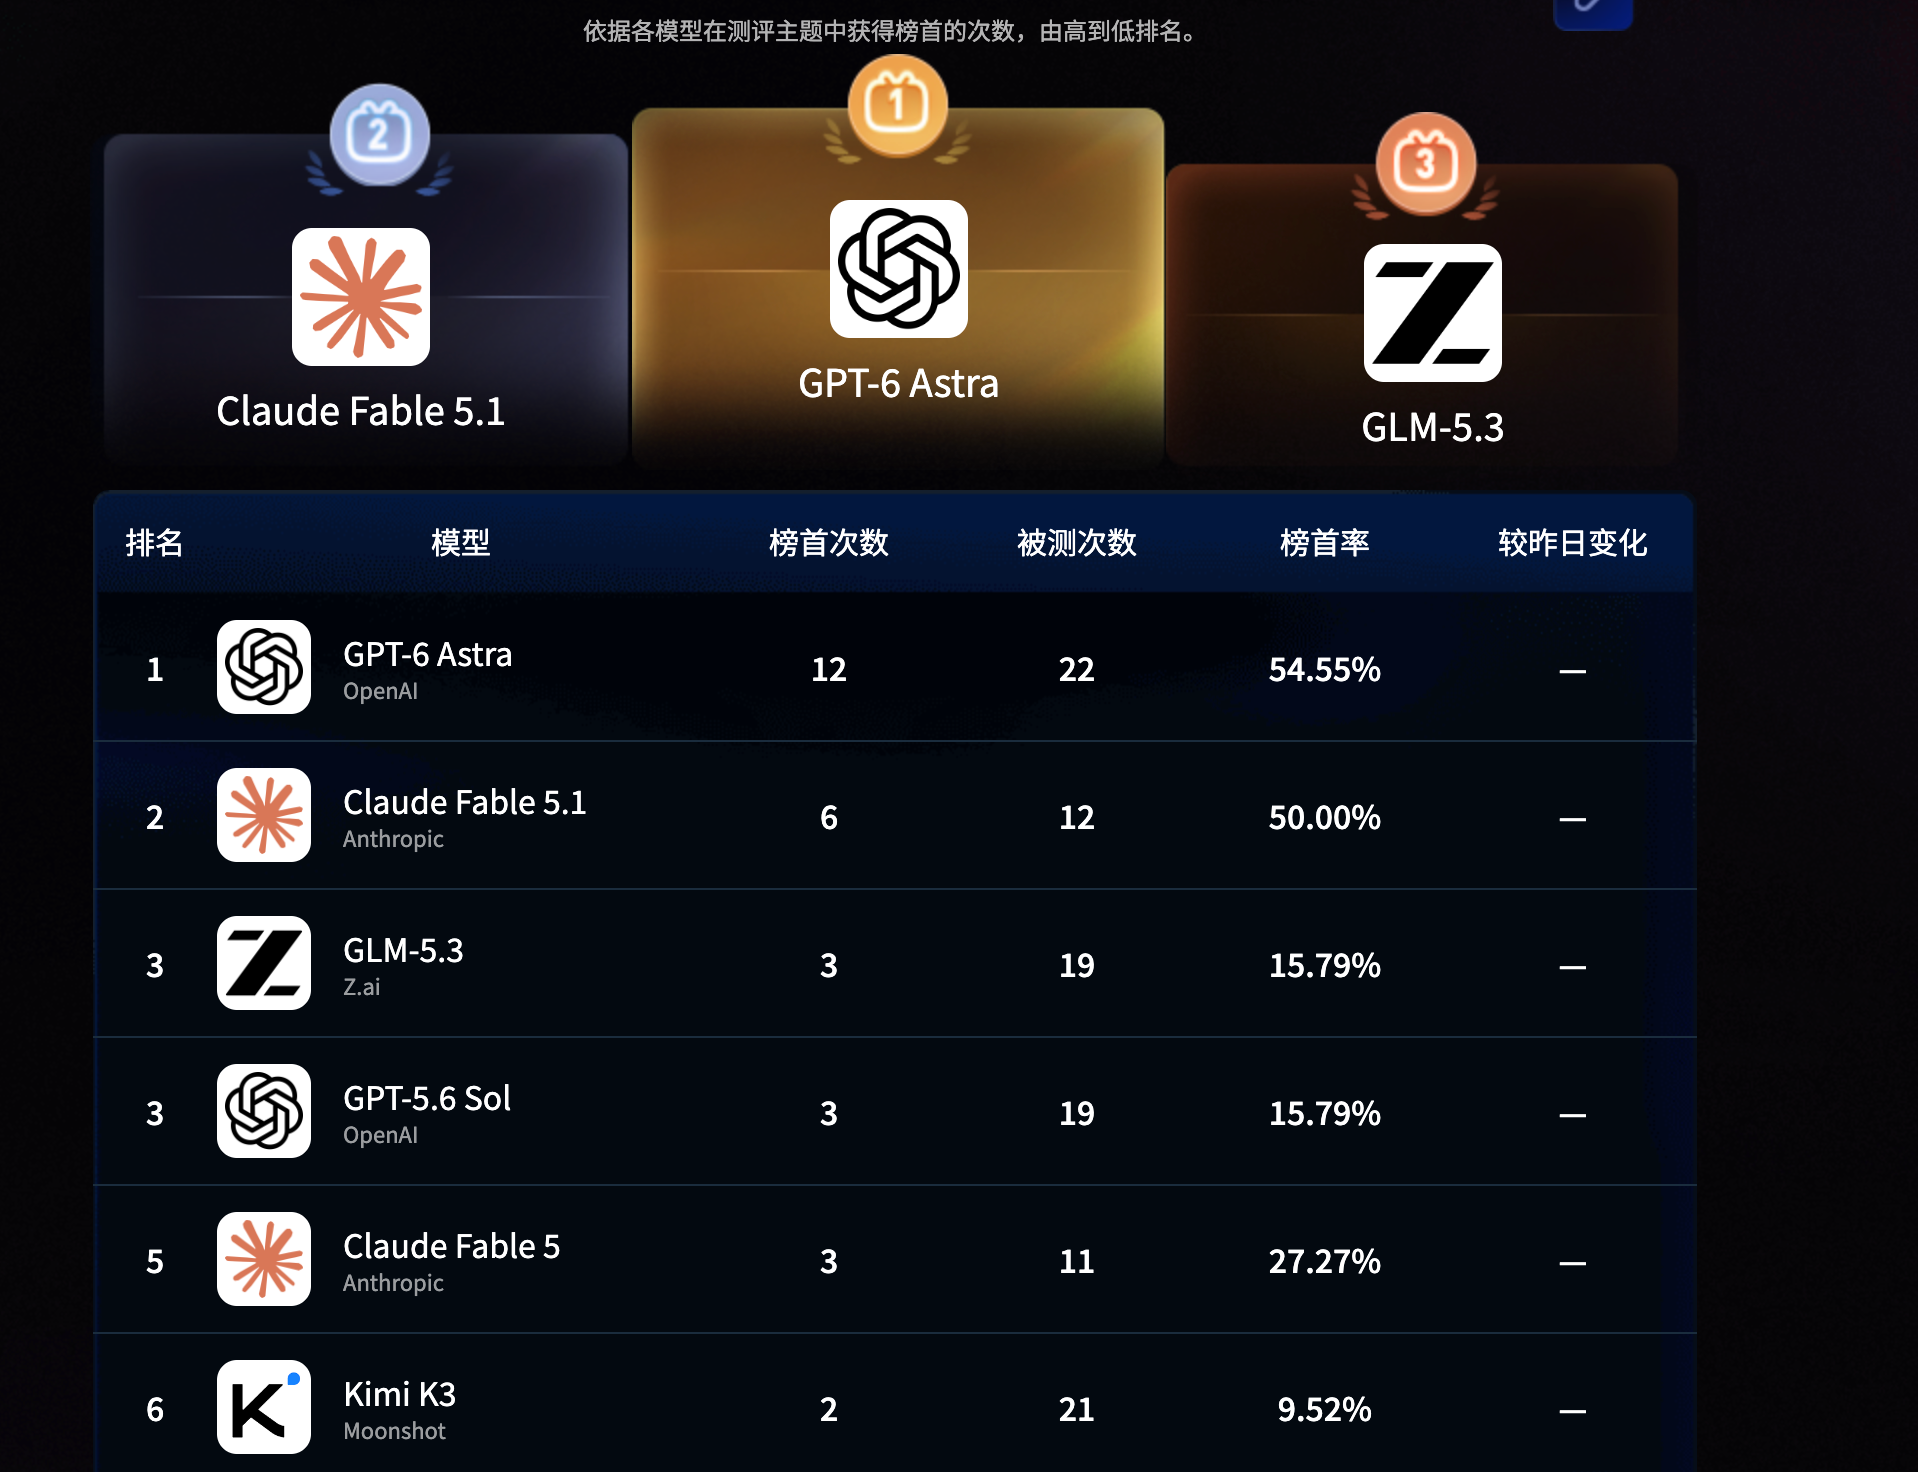
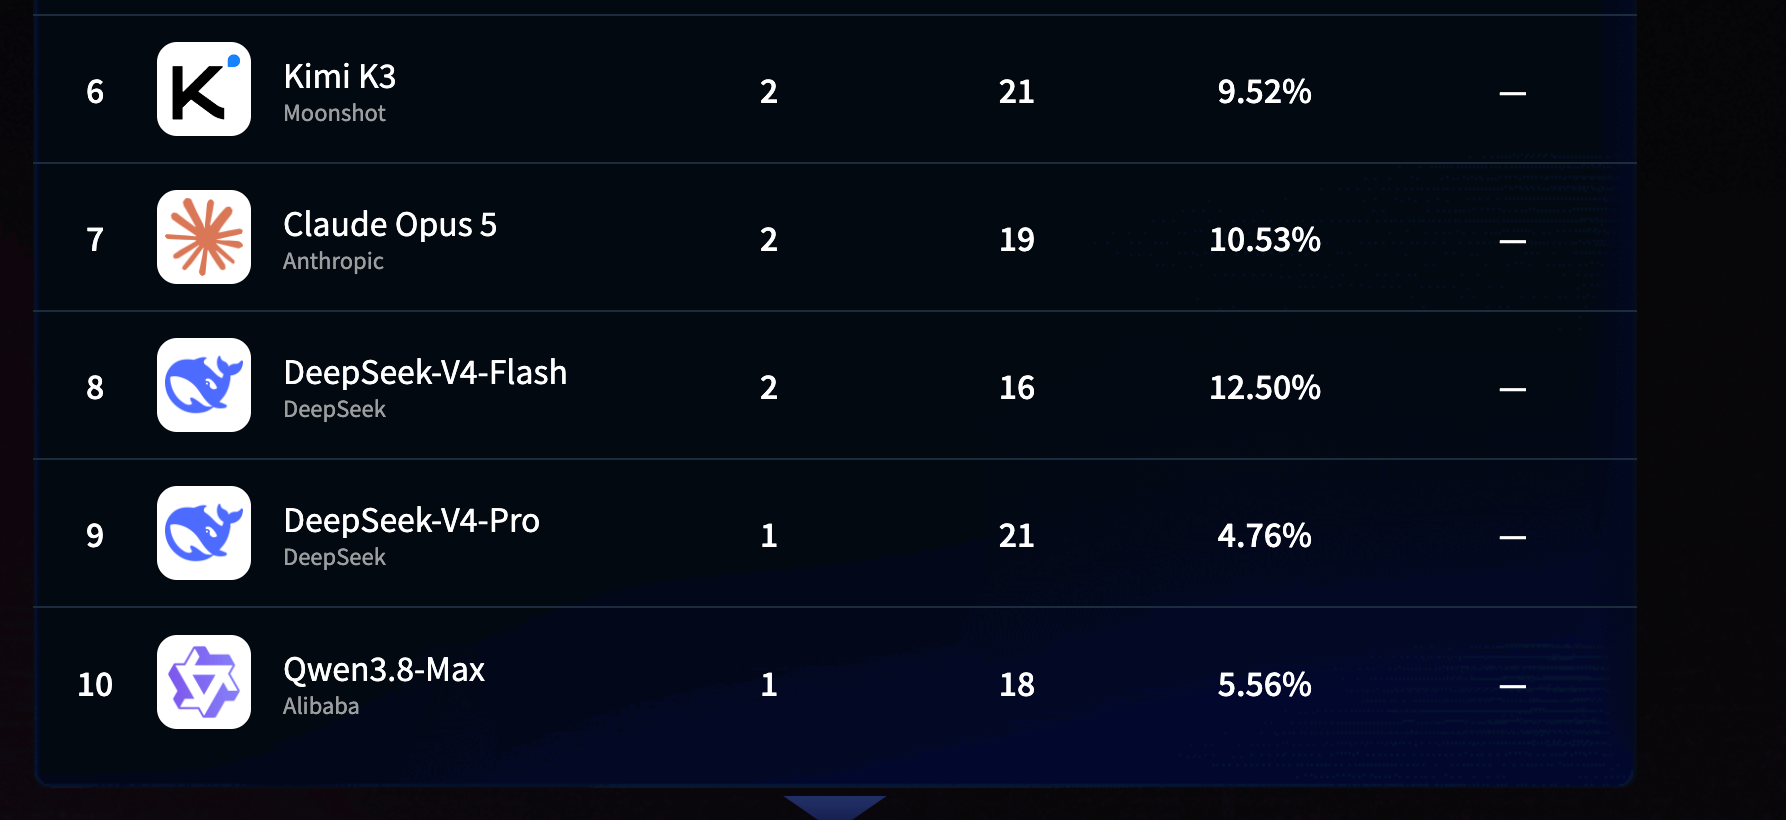
值得注意的是,GPT-6 Astra的领先并非压倒性的。其榜首率约为54.55%,意味着在近一半的UP主命题中,其他模型表现更优。这种“同题不同命”的结果,恰恰是B站想要呈现的效果——没有一个模型在所有场景中都绝对领先,真实使用中的差异远比跑分榜的位次复杂。
B站押注的底气:1.9亿月活用户
B站敢于做这件事,底气来自平台上AI内容的爆发式增长。公开数据显示,过去一年B站AI知识内容消费时长同比增长72%,月均观看AI内容的用户超过1.9亿人。围绕模型发布、讨论、测评、使用、求助、共建的内容已经形成完整体系。
这种生态规模的另一面,是B站已经事实上成为大模型走向大众的“第一讨论场”。当模型迭代速度快到传统跑分榜追不过发布节奏,把评测权交还给真实创作者和真实工作流,反而更贴近用户心里那句“到底哪个好用”。B站想做的,是把自家的社区生态变成大模型走向大众的另类裁判台。
大模型测评的信任危机,B站能破解吗?
B站此时入局,踩在了一个微妙的时间节点上。传统跑分榜的公信力正在经历前所未有的质疑。
分数通胀是第一个问题。主流基准测试的“试卷”难度已跟不上模型进化速度,头部模型成绩集体趋近满分,反而很难看出真实差距。刷榜成为行业潜规则,模型厂商提前“背题”甚至私下测试多个变体、只公布最优结果的操作屡见不鲜。此前Meta的Llama 4 Maverick在LMArena上冲到第二,但开源版本实际排名跌至第32位。考题与真实使用场景脱节,更是长期被诟病的痼疾。
B站的解法是把命题权交给UP主。不同分区、不同职业背景的创作者,带着各自领域的问题去测试模型——写代码的测代码能力,做视频的测脚本生成,做电商的测文案和数据分析。这种“分布式测评”能否比标准化考卷更贴近真实,还需要时间验证,但它至少提供了一种区别于厂商自说自话的第三方视角。
当然,B站的模式也有自身的局限。UP主的测评质量参差不齐,命题的可比性、评分的客观性都面临挑战。更重要的是,B站本身也是一个商业平台,如何确保榜单不被流量逻辑或商业合作影响,是它必须回答的问题。
当模型迭代快到跑分榜追不过发布节奏,“谁更强”这个问题正在变得越来越难回答。B站的答案是:不如换个问法——在真实的场景里,谁更好用。这个问题的答案,或许比任何跑分都更有意义。