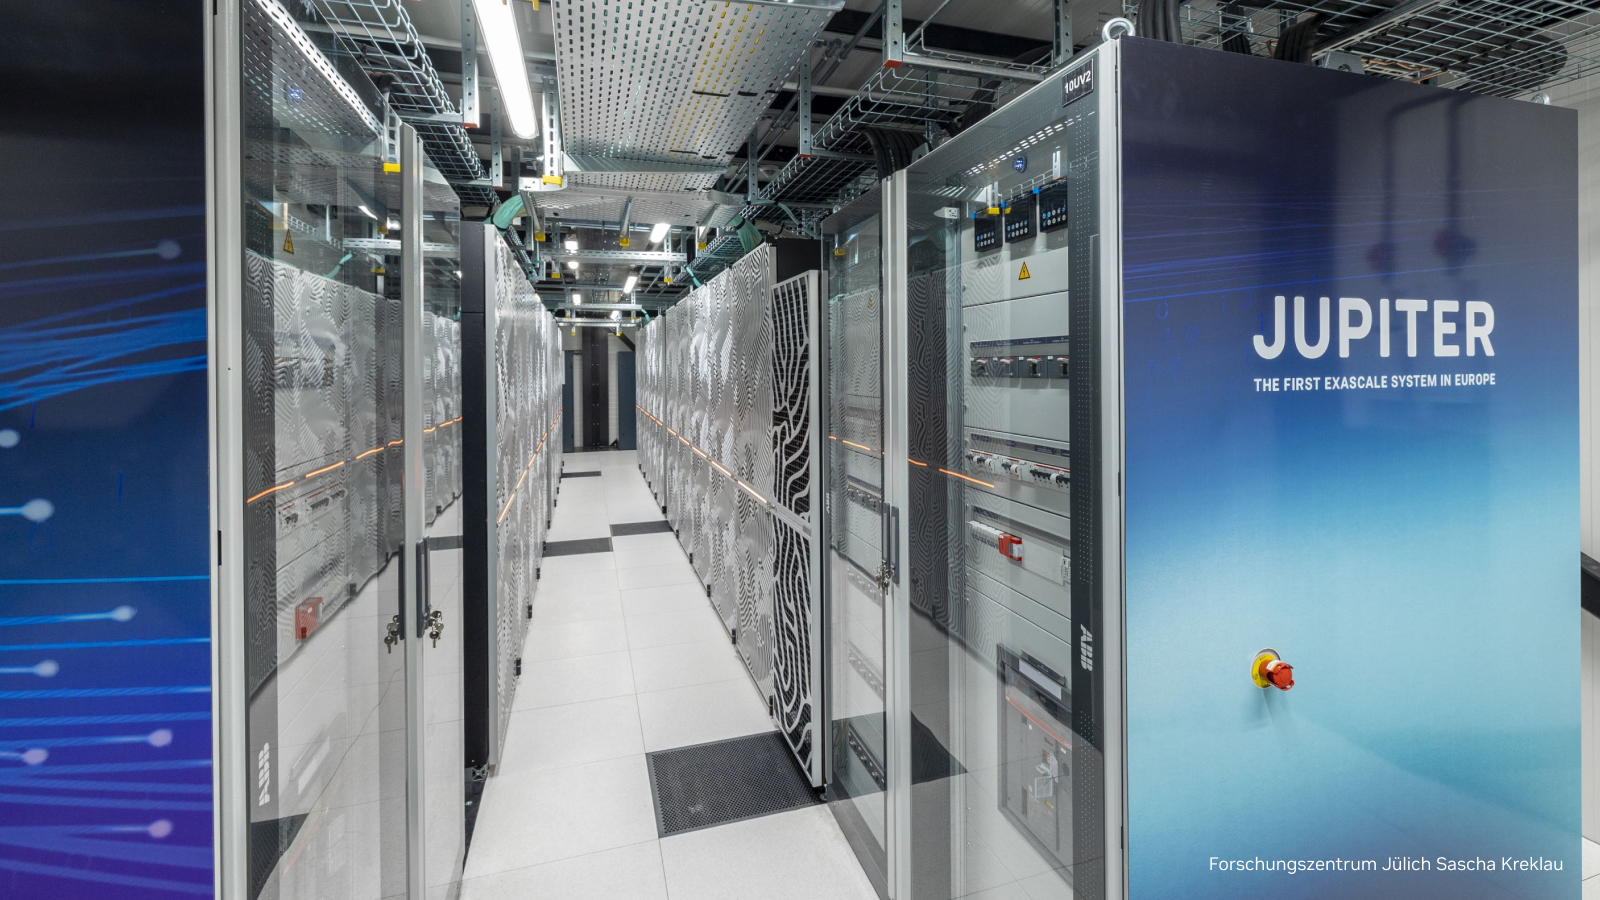
当地时间10月19日,英伟达在GTC Berlin 2026上宣布,其与德国于利希超算中心(JSC)合作,利用欧洲首台百亿亿次级超级计算机JUPITER上的8192块GH200 Grace Hopper超级芯片,完成了104量子比特容错量子计算系统的综合模拟。这是迄今为止针对容错量子计算系统规模最大、细节最完整的一次模拟。
更关键的是,研究团队在包含真实硬件噪声的条件下,验证了一种名为“魔态培育”(magic state cultivation)的容错技术路线。该路线所需的物理量子比特数量,比传统“魔态蒸馏”级联工厂减少约90%。
魔态:容错量子计算的“燃料”
要理解这次突破的意义,得先理解一个关键概念:魔态。
量子纠错中的许多操作属于Clifford操作,这类操作相对容易模拟,也相对“便宜”。但要实现通用量子计算,必须引入至少一种非Clifford操作。魔态,正是为这类操作提供“燃料”的特殊量子态。问题在于,容错量子计算机在运行中会持续消耗魔态,这意味着魔态的制备效率和质量,直接决定了整台机器的可行性与规模。
自2004年以来,业界的标准方案是“魔态蒸馏”:从大量含噪的原始态中,反复“提纯”出少量高精度态。代价是庞大的量子比特开销——蒸馏工厂可能占据一台量子计算机90%至95%的物理量子比特总量。
而“培育”(cultivation)的思路完全不同:不再大量蒸馏,而是在一个较小的纠错码中制备一个初始态,通过主动的错误检测将其“养大”,逐步扩展到大码距,最终得到足以使用的魔态。英伟达此次模拟的协议,从距离-3颜色码起步,利用新设计的flag测量检测有害故障,再扩展至距离-7的混合颜色/表面码配置,最终覆盖104个物理量子比特(含数据与辅助比特)。
为什么GPU超算是关键:从3分钟到“可行”
魔态培育的价值早已被理论认可,但验证它需要极其昂贵的计算资源。
此前,Jülich团队曾在理想、无噪声条件下模拟过50个量子比特。而这一次,模拟纳入了相干相位噪声和三能级泄漏——超导量子比特可能脱离常规的两个计算能级,进入第三个能级,这使模拟复杂度急剧上升。为了追踪约35.2万亿个复数振幅(分布在512 TiB的分布式GPU显存中),系统需要45比特编码的状态向量。
效率的跃升同样关键。据快科技报道,此前用普通CPU跑一轮解码器参数优化需要3分钟,过长的迭代周期使参数无法频繁更新,纠错效果随之变差。而GPU加速将原本需要数周的计算压缩至数天,让研究人员能够在硬件制造之前,就对不同设计进行高频次的“压力测试”。
英伟达创始人黄仁勋在声明中表示:“有用的量子计算将需要极其复杂的容错系统——理解它们在规模下如何行为,对建造它们至关重要。”JUPITER上的结果展示了量子处理器与GPU超算如何协同工作,“加速发现变革性的量子应用”。
英伟达的量子棋局:不做QPU,做“设计工具”
这次模拟本身不生产量子比特,但它揭示了英伟达在量子计算领域的一贯定位:不做量子处理器,做让量子处理器变得可设计、可验证的工具层。
支撑此次模拟的CUDA-Q和cuQuantum,是英伟达量子软件栈的核心。CUDA-Q是一个混合编程平台,允许开发者在GPU、CPU和QPU之间分配计算任务;cuQuantum则提供GPU加速的量子电路模拟与状态向量运算。团队先在英伟达加速量子研究中心(NVAQC)的GB200 NVL72系统上开发和验证模拟软件,再将其扩展至JUPITER的百亿亿级规模——这种“小规模调试、大规模执行”的流程本身,就是GPU超算赋能量子研究的范式演示。
与此同时,英伟达通过NVentures等渠道持续投资量子生态。2026年5月,其风投部门参与了法国量子公司Alice & Bob的B轮融资,后者正在推进容错量子计算机路线图,并与英伟达在CUDA-Q、cuQuantum及NVQLink(QPU-GPU互连技术)上深度合作。从软件工具、硬件互连到早期投资,英伟达正在量子计算的“设计层”建立自己的位置。
距离实用化仍有距离,但“预判”已经开始
必须明确的是,104量子比特的模拟不等于一台104量子比特的容错量子计算机已经存在。英伟达也指出,该进展距离实际应用仍存在技术挑战。魔态培育的物理实现、更大规模系统的噪声行为、以及从模拟到硬件的工程跨越,都还需要时间。
但这次模拟改变的是研发的节奏。当物理量子比特的开销可以被削减90%,当设计参数可以在数天内完成迭代而非数周,量子硬件的试错成本将大幅下降。英伟达和Jülich的这项工作,本质上是在为量子计算行业提供一种在硅片上“预演”量子未来的能力——在真正的硬件被造出来之前,先让它在超级计算机里跑起来、错起来、然后被修正。
这或许比任何单一的量子比特数量纪录都更具现实意义:量子计算的竞赛,正在从“谁先造出更多比特”,延伸到“谁先学会不浪费比特”。