9月21日,通义千问团队最新发布的 Qwen-Image-2.1 引发关注。这款新一代开源图像模型将文生图、图像编辑和透明图像生成整合到同一套模型中,其视觉生成组件仅有 7B参数,同时支持最高10张参考图输入,并针对推理效率和显存占用进行了优化。
相比单纯追求更大参数规模,Qwen-Image-2.1此次更强调“小模型+多能力”的组合。官方表示,该模型希望在图像质量、推理效率和使用成本之间取得平衡。
7B参数实现文生图与图像编辑一体化
 Qwen-Image-2.1的视觉生成模块采用 32层 Single-Stream DiT 架构,参数量为7B,同时结合混合粒度注意力机制和 Prefix KV Cache 复用,以减少多步生成过程中重复计算带来的开销。
模型不仅可以根据文字生成图片,也能够直接对输入图片进行编辑。官方提供的使用方式显示,同一个 Pipeline 可以处理文生图、单图编辑以及多参考图编辑等任务。
在多图编辑场景中,Qwen-Image-2.1最多支持 10张参考图片,可以将不同人物、服装、配饰或其他素材组合到同一画面中,同时尽量保持参考主体的特征。
透明背景成为这次升级的重点
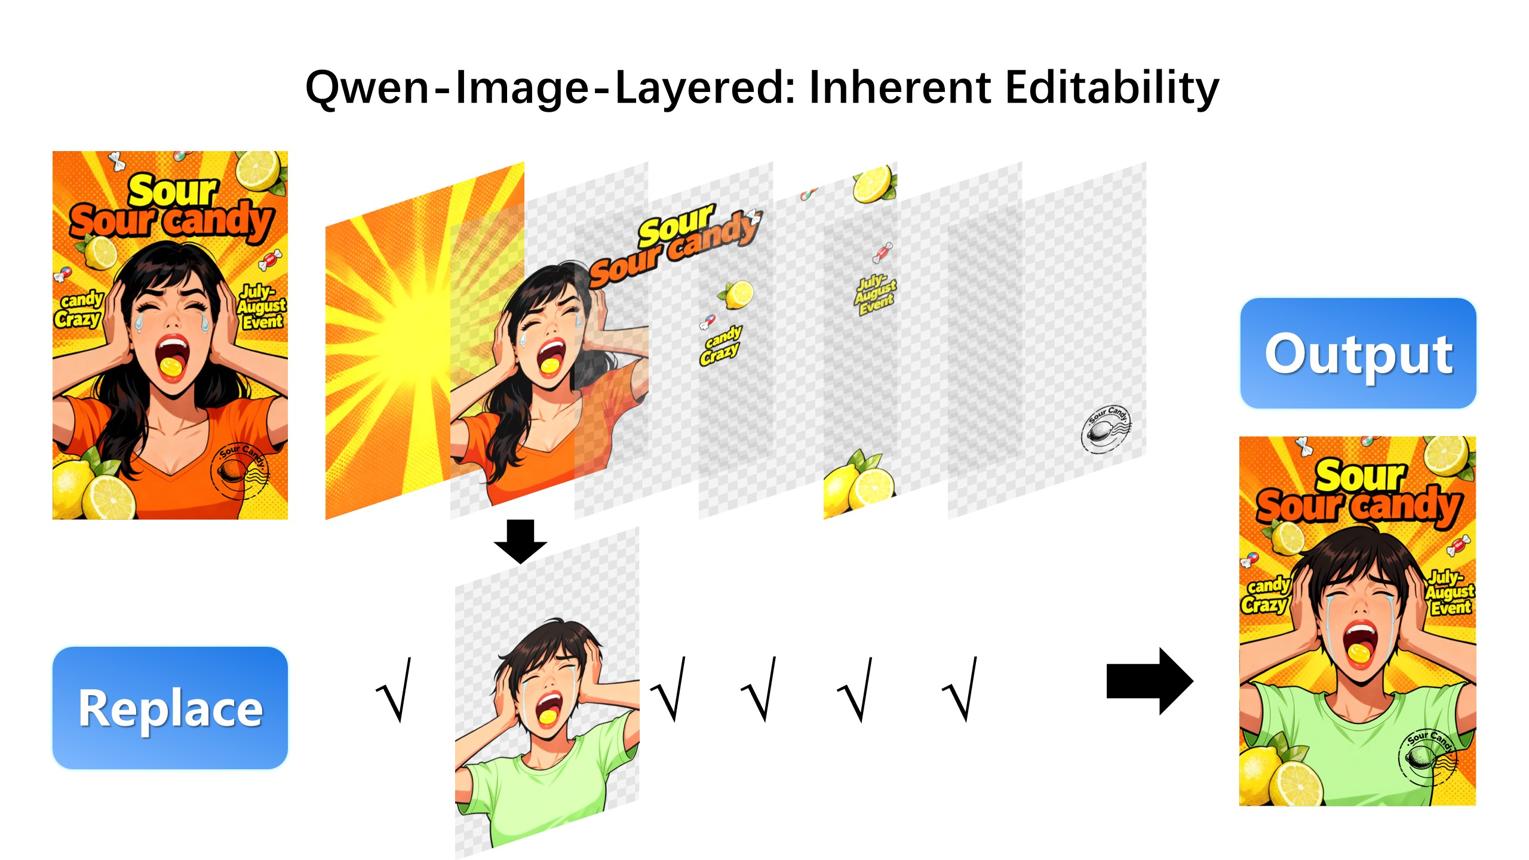
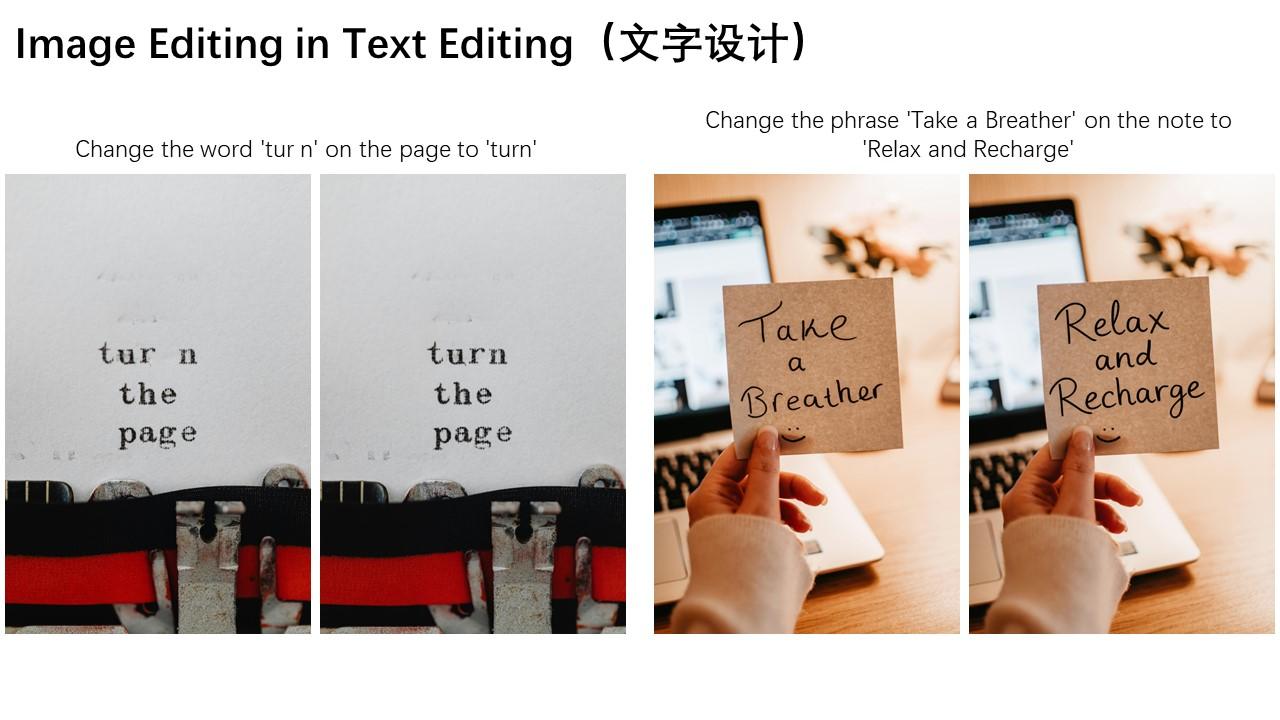 这次更新比较特别的一项能力,是模型原生支持 RGBA透明图像生成。
用户可以直接通过提示词要求生成透明背景图片,也可以对已有的透明图层进行编辑。例如修改主体表情、调整局部内容,甚至直接修改透明图层中的文字,而不必重新制作整个画面。
对于电商商品图、贴纸、IP形象、海报素材等场景,这种能力可以减少抠图、换背景和二次处理的步骤。模型还支持从真实照片中提取主体,并生成带透明背景的素材。
多参考图编辑进一步扩大使用场景
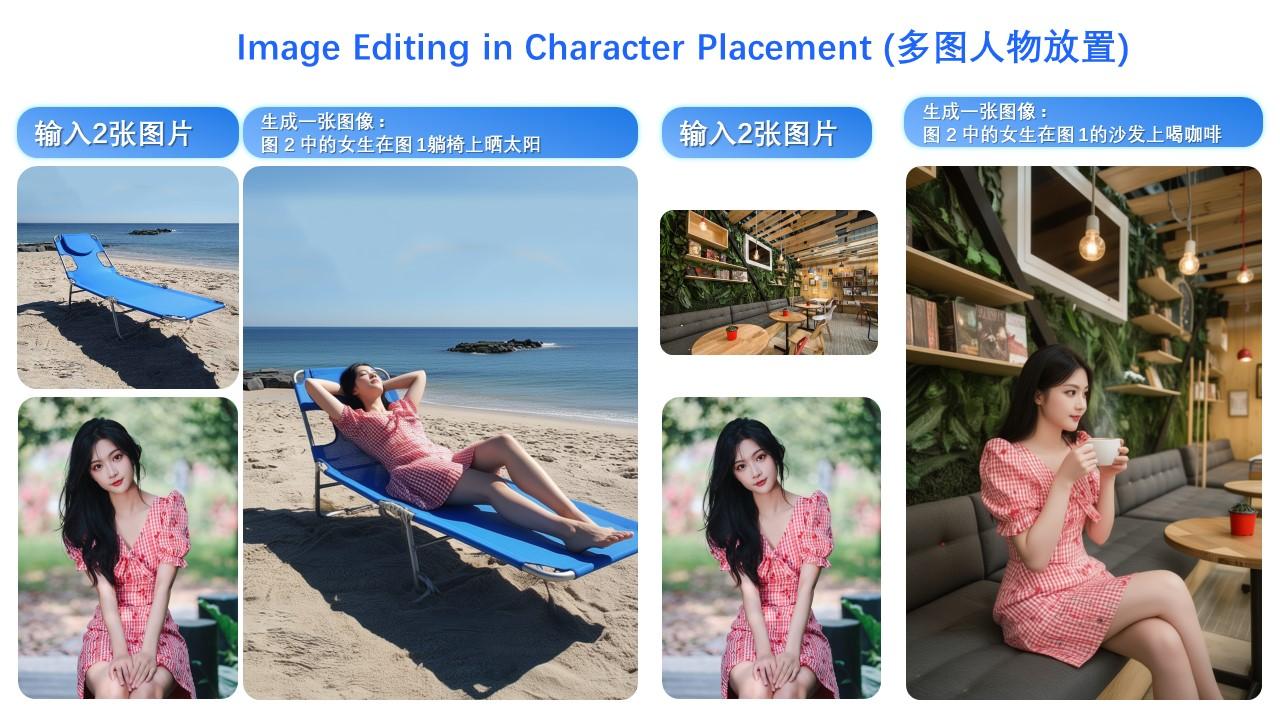 除了透明图像,Qwen-Image-2.1也强化了局部编辑能力。
用户可以通过圈选、涂抹或独立Mask指定需要修改的区域,并输入最多10张参考图片,让模型综合不同素材生成新的画面。官方展示的案例包括多人合成、完整穿搭组合以及人物局部修改等任务。
同时,模型继续强化文字渲染、人像光影和细节表现,并支持全景图、信息图和分镜图等不同类型的视觉内容。官方还提供了2K原生分辨率支持,包括1:1、16:9、9:16等多种比例。
开源生态同步跟上
Qwen-Image-2.1目前已经在 GitHub、Hugging Face和ModelScope等平台开放模型权重,同时获得 Diffusers、ComfyUI、vLLM-Omni、SGLang等工具的支持,开发者可以直接将其接入现有的图像生成工作流。
不过需要注意的是,虽然模型被称为“开源”,其官方仓库采用的是 Qwen Research License Agreement。按照许可证说明,材料的免费许可主要面向非商业用途,如果用于商业目的,需要向通义千问团队申请单独的商业许可。
从这次更新来看,Qwen-Image-2.1并没有单纯把重点放在参数规模上,而是试图让生成、编辑、透明图层和多参考图处理集中到一个模型里。对于开发者和创作者来说,真正值得关注的,或许是它能否进一步减少传统AI绘图工作流中“生成一次、再抠图、再修图、再合成”的反复操作。